机器学习数学基础
线性代数
如何表示和组织数据
向量基础
- 特征向量
计算机世界,所有的东西其实都是向量,如果一个向量是由多个特征组成的,则这个向量就是一个特征向量
如一个房价的特征向量:
x=(面积,卧室数,卫生间数,房龄,距地铁站距离)
对于一套 90 平米、两室一卫、房龄 5 年、距地铁站 500 米的房子,其特征向量可以表示为:
x=(90,2,1,5,500)
要构建一个预测房价的机器学习模型,实际上就是在这个五维向量中寻找规律
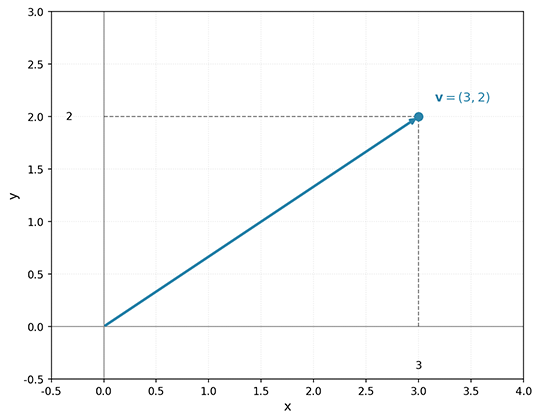
如图是一个2维向量,v点是向量的一个分量,整个线上的所有点组成了向量。
| 表示形式 | 形状 | 数学表示 | 说明 |
| :——- | :——- | :——————————— | :——————— |
| 一维数组 | (n,) | [v1v2⋯vn][v1v2⋯v**n] | 只有长度,无行列之分 |
| 行向量 | (1, n) | v=[v1v2⋯vn]v=[v1v2⋯v**n] | 1 行 nn 列的二维数组 |
| 列向量 | (n, 1) | v=[v1v2⋮vn]v=v1v2⋮v**n | nn 行 1 列的二维数组 |
数据集:由多个向量组成的一个数据的集合。
- 线性相关与线性无关
对于一组向量 v1,v2,…,vkv1,v2,…,vk,存在不全为0的标量c1,c2,…,ckc1,c2,…,c**k,使得 c1v1+c2v2+⋯+ckvk=0c1v1+c2v2+⋯+ckvk=0,则称这组向量线性相关。否则这组向量线性无关。
线性无关意味着没有任何一个向量可以被其他向量表示。则数据集中不存在冗余数据。
数据科学用秩来衡量数据之间的相关性,秩指向量组中线性无关向量的最大个数。满秩:每个数据都有意义,不满秩:存在可以移除的冗余量。
特征选择:如果特征矩阵的秩小于特征数,说明存在冗余特征。
数据压缩:秩分解可以实现低秩近似,用更少的参数近似原矩阵,降低维度,减少空间。
奇异值分解:秩等同于非0奇异值个数,决定了有多少东西值得保留。
模型LoRA微调:只训练“低秩适配器”,不动原模型,用极少参数实现高效微调。
- 向量相加
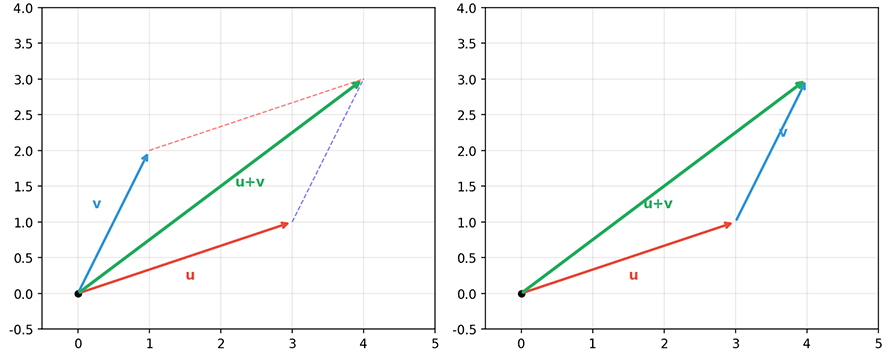
平行四边形法则:将两个向量 uu 和 vv 的起点放在同一点,以它们为邻边作平行四边形,从公共起点出发的对角线就是 u+vu+v。
三角形法则:将 vv 的起点放在 uu 的终点,从 uu 的起点到 vv 的终点的向量就是 u+vu+v。
- 向量相乘
当 c>0c>0:向量的长度缩放为原来的 ∣c∣ 倍,方向不变
当 c<0c<0:向量的长度缩放为原来的 ∣c∣ 倍,方向反向
当 c=0c=0:结果为零向量 0
矩阵基础
矩阵是向量的自然扩展,也是线性代数的核心研究对象。
矩阵:由标量按行列排列组成的矩形阵列。

矩阵是机器学习的"原材料",把矩阵想象成一张数据表格,每行是一个样本(譬如一位用户、一张图片),每列是一个特征(譬如年龄、价格、像素值)。这种结构让计算机能高效处理成千上万的数据点。
- 矩阵的逆:将一个已经变换了的矩阵,恢复到原来状态的操作。

如图的两个矩阵,一个是转换后,一个是原始,进行求逆时发现,2,3,为1,1,其他位置为0,0。为1的位置表示可以恢复,为0的位置表示无法恢复。(因为值已经发生了变化)。
这在记忆压缩时常使用。
- 矩阵向量积:h=Wx+b 其中 xx 是输入向量(上一层的输出),WW 是权重矩阵,bb 是偏置向量,hh 是本层的输出。权重矩阵 WW 把输入从 nn 维空间映射到 mm 维空间(WW 为 m×nm×n 矩阵),这个映射过程就是一次线性变换。
将一组向量进行转换,从原来变成另一种的过程。
- 张量:标量、向量、矩阵在高维空间的自然推广,可以描述任意维度的数据及其转换关系。
| 阶数 | 名称 | 维度描述 | NumPy 表示 |
| :–: | :——— | :——————————- | :————————– |
| 0 | 标量 | 无方向,只有大小 | x (标量值) |
| 1 | 向量 | 一行或一列 | shape = (n,) |
| 2 | 矩阵 | 行 × 列 | shape = (m, n) |
| 3 | 三阶张量 | 行 × 列 × 通道 / 深度 | shape = (h, w, c) |
| nn | nn阶张量 | 维度 1 × 维度 2 × … × 维度nn | shape = (d₁, d₂, ..., dₙ) |
深度学习的所有数据都使用张量表示。
微积分
从数据中学习和改进
极限、导数与微分
- 极限:当自变量无限接近某个值时,函数值的变化趋势。

对与上面的函数:当x无限趋近于1时(x永远不等于1),函数的值越来越接近2
这就是一个极限的概念,
- 导数的定义和几何意义

如图,我们如何计算一个物体的瞬时速度,我们只能根据时间和路程求出某个物体的平均速度。但是如果我们不断缩小时间,则无限小的时间短内的平均速度就相当于此物体的瞬时速度。
- 常见函数的导数
幂函数
f(x)=xnf(x)=x**n

指数函数和对数函数

三角函数
| 函数 | 导数 |
| :——— | :————————— |
| sinxsinx | cosxcosx |
| cosxcosx | −sinx−sinx |
| tanxtanx | sec2x=1cos2xsec2x=cos2x1 |

- 微分和线性近似:微分可以理解为导数的另一种表达形式。 微分和导数的区别在于导数是一个比值dy/dx,而微分dy和dx是独立的量。 微分的一个重要应用是线性近似,目的是将函数复杂计算转化为相对简单的微分计算。
导数是揭示了一个朴素却深刻的思想,任何连续变化的量,都可以通过它在某一点的变化趋势来刻画。从牛顿当年思考的瞬时速度问题出发,导数将平均变化率推向极限,得到了瞬时变化率的精确表达。这一从静态比值到动态极限的跨越,不仅是数学的进步,更是思维方式的转变,我们从此可以用一个数值来描述一个函数在某一点的变化倾向。几何上,导数是切线的斜率,这提供了我们用直线(线性)来理解曲线(非线性)的途径。
微分则将抽象的变化率转化为具体的变化量,让我们能够通过线性近似来简化复杂的函数计算。这一思想在机器学习中体现得尤为明显,泰勒展开将复杂函数分解为一系列多项式,梯度下降依赖一阶导数指引优化方向,而损失函数的凹凸性由二阶导数揭示,这些都是微分学在现代人工智能中的直接应用。极限、导数、微分、高阶导数这些概念层层递进,构成了理解连续变化世界的数学框架,也为下一章学习多元函数微分学奠定了坚实基础。
多元函数和复合函数求导
- 偏导数:对于一个多元函数,如果只让其中一个变量变化,而保持其他变量不变,函数值会如何变化。表示此变化的导数就是偏导数。
- 梯度:偏导数表示函数沿每个坐标轴方向的变化率。如果把所有坐标方向的偏导数组合在一起,就可以得到一个向量,称为梯度。
- 复合函数和链式法则
复合函数:一个函数的输出是另一个函数的输入。多个函数嵌套在一起组成的复杂函数。
链式法则:为何解决复合函数问题的有力工具。复合函数的导数等于各层函数导数的乘积。
- 积分:微分研究的是局部变化率,是指在某一点处,函数指变化的快慢。积分则是研究全局累计量,即在一个区间上,函数值的总体效果。
统计和概率
线性代数是机器学习的数据语言,它告诉计算机如何表示和组织数据。
微积分是机器学习的优化行为,它告诉计算机如何从数据中学习和改进。
统计与概率就是机器学习的决策思想,它告诉计算机如何在不确定的世界中做出理性的判断和预测。
概率基础
- 概率性思维:传统软件开发的一贯思维方式是确定性的。同样的输出永远产生同样的输出,代码逻辑明确的,可预测的,发生错误是可以精确定位和修复的。 机器学习的思想是从数据中学习规律,而不是由人工设计规则。机器学习的预测结果和过程天生就带有概率性。模型的输出不是正确答案,而是最可能的答案。 期望:概率分布的中心位置,随机变量取值的平均值。
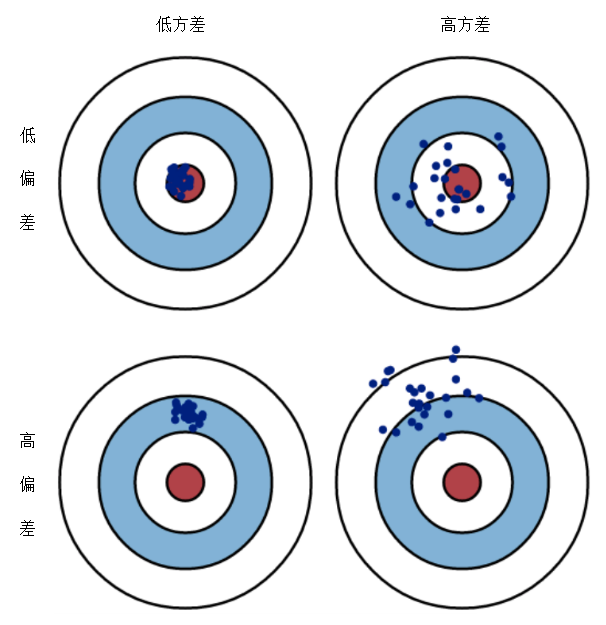
偏差:衡量预测的期望值和真实值之间的差距。
偏差越大,模型越不准确,偏差越小,模型越准确。
方差:期望用来描述概率的分布的中心位置,但不能用来表示大部分概率对于中心的相对关系。
- 常见的概率分布
伯努利分布:对数据进行二分,直接根据二分来判断概率问题。

正态分布:中心高,两侧对称下降。
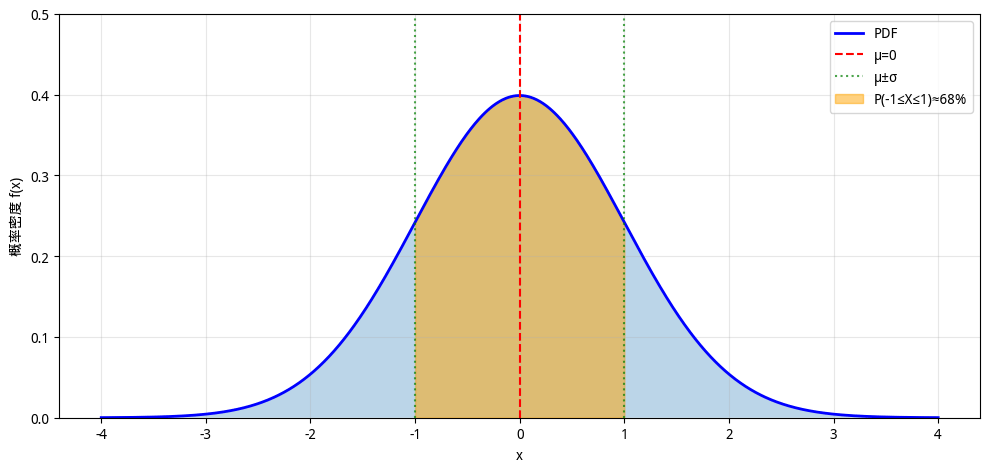
自然界许多现象都近似服从正态分布,人的身高、高考成绩、测量误差等。
有明确范围,且没有正向强化(本次的增加或减少和上次没有关系)的数据,都呈现正态分布

有明确界限,却存在正向强化的数据(如金钱,知识等)呈现帕累托分布

指数分布:两次事件之间间隔多长时间,连续的。
泊松分布:稀疏事件的时间分布。
用一个网站举例:
泊松分布可以预测下一分钟会收到多少请求。
指数分布可以预测下一次请求什么时候到达。
- 贝叶斯定理:对于传统概率中,事件往往是相互影响的。如A事件发生,我们可以推导出B事件发生的概率。(可以通过大量的历史数据推导出概率) 对于贝叶斯定理,则是一种反向推导。如果B发生了(已观察到),则需要推导出A发生的概率。

假设现在有一个抛硬币的机器,但是我们不知道这个机器是否公平。我们需要不断的尝试结果,然后通过贝叶斯定理来推算出抛出正面的概率。尝试次数越多,概率越准确。
统计推断
当我们训练一个模型时,本质上就是在做统计推断,从有限的训练数据推断模型参数,然后用这些参数预测新数据。
- 点估计
用样本数据推断总体参数的值或范围。我们无法观测整个总体,只能从有限的样本中推断总体特征。
最大似然估计:选择那个让当前观测数据最可能出现的参数值作为估计结果。
根据大量数据的统计结果,直接估算出概率。
最大后验估计:除了观察数据,还纳入我们对参数的先验知识,找到让后验概率最大的参数值作为估计结果。
在估算结果前,应该根据业务有一个理论的先验结果。然后根据验证后的样本概率,和先验概率结合。(默认与先验结果差距过大的概率是极端情况)
无偏性:(平均)估计量的期望值正好等于真实参数值。估计值的平均值会收敛到真实参数。
一致性:(数量)当样本数量无限大时,估计量就相当于真实参数。数据越多,估计越准。
- 假设检查:验证某个关于参数的假设是否成立。 不直接证明某个假设成立,而是反过来看证据是否足够推翻这个假设。因此,假设检查的结论永远只有拒绝或不能拒绝两种,没有接受的说法。也就是说,只能证明现在的假设目前无法推翻。但不能说明假设一定是对的。
对应AI的特征选择:ai很可能会进行多种尝试,但如果有证据证明不能这样做,则AI会打断这种方向。
经典统计学习方法
线性模型
线性回归
- 线性假设
控制变量,根据参数来统计不同数据落在平面坐标系上的点,来画出数据分布的大致线。然后根据斜率等推算出不同变量对数据的影响情况。
假设-> 准则-> 解法。线性假设简化了世界,将复杂的关系压缩为一条直线。
线性回归的价值不在于能直接使用它解决哪些问题,而是许多更复杂的模型与它一样,共享同一套从数据中学习规律的思维范式:先假设一个模型结构(某种关系假设),再定义一个优化准则(什么样的解是好的),最后找到最优参数(如何求解)。
逻辑回归
- Logistic 函数
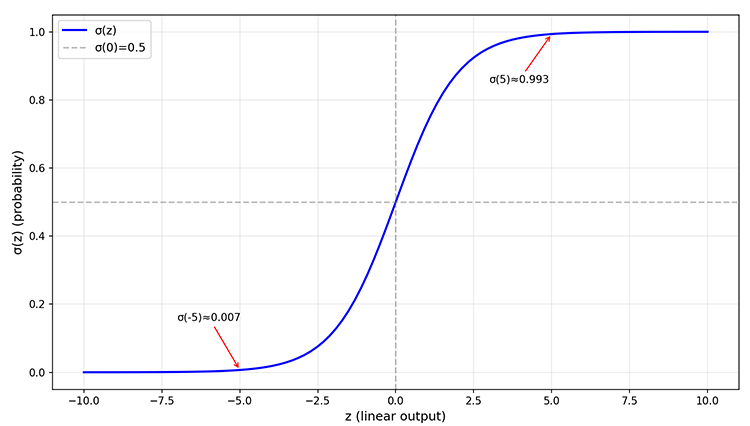
用于描述人口增长的模型,当人口少时,增长慢,人口适中,增长快,人口达到上限时,增长趋于饱和。
逻辑回归用回归思想解决分类问题,核心设计是线性决策 + Sigmoid 翻译,它仍然归类在线性模型之中,继承了线性模型的优点,可解释性强、小样本稳健,但也存在线性决策边界、特征交互缺失、对不平衡数据敏感等局限。
正则化与广义线性模型
正则化是线性模型、神经网络等许多模型的通用技巧,但因为线性模型的参数直接对应特征影响力,正则化通过约束参数大小,既能防止过拟合又能保持模型的可解释性。
- 拟合和泛化:机器学习的目标不是记住训练数据,而是学会预测未知。泛化指的就是模型从训练集学到的知识迁移到测试集的能力,训练是“课本”,测试集是“考试”,学的好不好考试说了算。 训练误差大、测试误差大:欠拟合,模型本身训练不够,训练是从欠拟合到拟合的过程。模型需要继续优化。
训练误差小,测试误差小:泛化好,模型学到了真实的规律,是理想结果。
训练误差小、测试误差大:过拟合,说明模型的泛化模拟差,需要调整模型结构,改变训练方式手段。
- 正则化原理:限制模型的复杂度。通过在损失函数中加入参数惩罚项,达到限制模型复杂度的目的。 L1正则化Lasso:用于约束模型参数的数量,能让某些参数精确为零。参数为零意味着对应的特征被剔除,模型只学习真正有用的特征。稀疏性。
L2正则化,岭回归:约束模型的参数大小,让参数估计更稳定,但通常不会让参数精确为零。参数收缩意味着模型中所有特征的响应都变得更加温和,降低了单个特征的过度依赖。
| 特性 | 岭回归(L2) | Lasso(L1) |
| :——–: | :—————-: | :———————-: |
| 参数约束 | 收缩但不为零 | 可精确为零(稀疏) |
| 特征选择 | 不自动选择 | 自动选择 |
| 计算复杂度 | 有闭式解,计算快 | 需迭代优化 |
| 共线性处理 | 参数趋于相近,稳定 | 随机选择一个为 0,不稳定 |
| 适用场景 | 特征都相关时 | 需要特征筛选时 |
贝叶斯方法
当我们获得新证据时,该如何更新之前的认知。
朴素贝叶斯
- 贝叶斯分类
贝叶斯认为,分类任务就是计算给定特征下属于各类别的概率,选择概率最大的类别。

朴素贝叶斯是将多个参数同时出现才能做分类判断的场景,修改为每个分类相互独立,然后把分类概率的指标变成每个分类的概率相乘。
这样做不符合现实,但却可以将原来指数级别的可能降维。使多维分类变为可行
分类只关心相对大小:朴素贝叶斯的概率估计可能不准确,但只要分类的相对顺序正确,分类结果就是正确的。
决策边界的简化:朴素贝叶斯的决策规则变为线性形式。(线性分类器)
偏差-方差权衡:朴素贝叶斯引入了偏差,概率估计不准确。但同时大大减少了方差,让概率评估更稳定。
一把刻度不对的粗糙尺子,虽然每次测量都有误差,但误差方向一致,多次测量后反而得到相对可靠的结论。

- 离散型朴素贝叶斯实践:用于特征为离散值的场景。(词频、类别标签) 先假设数据的概率分布结构,再从数据中估计分布参数,最后用概率规则做出决策。
贝叶斯网络
- 图结构:朴素贝叶斯将各个特征相互独立,联合概率分解为各条件概率的乘积,大幅降低了复杂度,但也付出了精度的代价,丢失了特征之间的关联信息。
贝叶斯网络用图结构显性表达变量之间的依赖关系,只建模依赖,间接依赖通过图结构推导。
贝叶斯网络属于有向无环图,其中的节点表示随机变量,有向边表示A直接影响B,无环说明不存在循环路径,确保因果关系的合理性,不会出现倒果为因的情况。

- 条件独立性:给定其父节点后,该节点条件独立于所有非后代节点。

P(吸烟,肺癌,呼吸困难,剧烈咳嗽)=P(吸烟)⋅P(肺癌∣吸烟)⋅P(呼吸困难∣肺癌)⋅P(剧烈咳嗽∣肺癌)
EM算法
- 期望最大化

当面对不可观测变量时,通过期望E和最大化M的交替迭代,逐步逼近真实,在每一步都保持对不确定性的尊重。
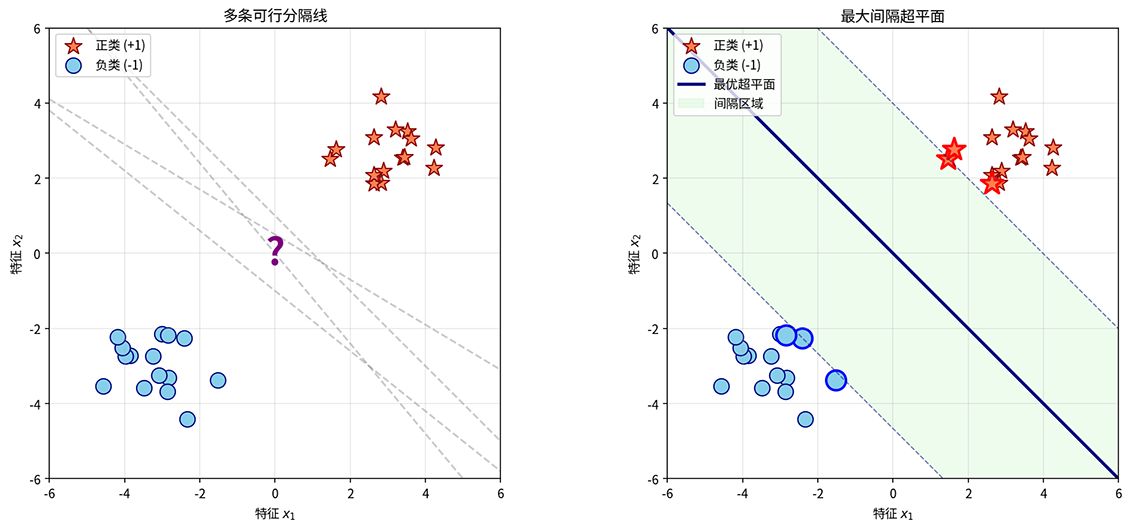
支持向量机
解决噪声和重叠问题。
决策树与集成
决策树
用一系列是与否来分类问题,计算机常用的分类方法
最佳分裂准则:对于现实中成千上万的特征,必须有一套严格的理论去判断每个节点应该选择哪个特征来分裂。 信息增益:根据熵做依据来决定是否分裂此特征。无论事前做多少数据统计,都无法确定下一次的结果(两种、或多结果的出现的概率均衡,没有大比分的情况),这种信息混乱的状态,信息熵最大。如果已经可以百分之百预测下一次的结果,那这时,信息熵为零。
决策树算法
ID3算法:
- 检查终止条件:如果当前数据集中所有样本属于同一类别,直接返回叶节点。
- 选择最佳分裂特征:计算每个特征的信息增益,选择增益最大的特征作为当前节点的分裂特征。
- 创建分支:对选中特征的每个取值,创建一个分支。每个分支对应一个子数据集,包含原数据集中该特征取值的样本。
- 递归构建子树:从特征集中移除当前分裂特征,对每个分支的子数据集递归调优上述过程,直到满足条件。

只能处理离散特征,要求每个特征有明确的取值类别,面对一些连续数据,必须人为分类等级,离散的数据划分标准本身缺乏客观依据。
C4.5算法
- 使用增益率而非信息增益作为分裂准则。
- 允许直接处理连续特征,无需预离散化。
- 能够处理缺失值。
- 引入剪枝防止过拟合。采用悲观剪枝,在构建树后,从叶子节点向上检查每个内部节点,如果将其替换为叶子节点能降低估计的误差率,就进行剪枝。(减少了分裂和选择次数)
- 剪枝策略
预剪枝:在树生长的过程中设置限制条件,防止过度分裂。
- 最大深度限制:预定树的最大层数,限制树深度。
- 叶子节点最小样本数:规定每个叶子节点至少包含多少样本。如果某个分支样本数过少,就不进行分裂。
- 分裂最小增益阈值:规定分裂必须带来的最小信息增益或Gini指数。
使计算效率变高,树不会增长的太大,训练时间短。缺点是可能过早停止,错过一些真正有用的分裂。
后剪枝:先让树完全生长,然后再从叶子节点向上剪枝。
- 悲观剪枝(C4.5):计算每个内部节点替换为叶子节点后的估计错误率,与当前子树的估计错误率比较。如果替换后错误率更低就剪枝。
- 代价复杂度剪枝(CART):引入参数α ,平衡树的复杂度和错误率。
- 最小错误剪枝:直接计算剪枝后错误率是否降低,比悲观剪枝更直接,但不考虑统计修正。
树完全生长后再剪枝,不会错过潜在有用的分裂。缺点是计算量大,需要完整生长一棵树,然后逐步剪枝和验证。
随机森林
Bagging思想:通过自助采样构建多个与原始训练集等大的新训练集,让每个模型看到不同的数据,学到不同的规律。

特征随机:在每个节点分裂时,不是从全部d个特征中选择最优分裂,而是随机选取m个特征,再从这m个特征中选择最优分裂。
避免单特征影响过大,而导致每次分裂出的树都大同小异。
- 聚合预测:多颗决策树训练完后,如何决定投票结果。
- 硬投票:每个模型预测一个类别,选择得票最多的类别,少数服从多数。
- 软投票:考虑预测置信度的方式,每个模型输出各类别的概率预测,对各类别概率取平均后选择最大概率类别。
| 树 | P(A) | P(B) | P(C) | 硬投票预测 |
| :–: | :–: | :–: | :–: | :——–: |
| 1 | 0.8 | 0.1 | 0.1 | A |
| 2 | 0.5 | 0.4 | 0.1 | A |
| 3 | 0.3 | 0.6 | 0.1 | B |
- 硬投票:A 得 2 票,B 得 1 票 → 预测 A
- 软投票:平均概率 [P(A)=0.53,P(B)=0.37,P(C)=0.10][P(A)=0.53,P(B)=0.37,P(C)=0.10] → 预测 A
提升方法
积弱成强
- Boosting思想:采用串行方式,让每棵新树专注于纠正之前所有树的累计错误,逐渐改进效果,最终通过精心设计的加权组合,令整体性能得以大幅提升。每个学习器都只做自己擅长的事,最终积小胜终成大胜。
- 加权训练:通过调整样本权重来聚焦困难样本,对于前一个学习器错误分类的样本,增加权重,让后续学习器重点关注。对于正确的减少权重,降低关注度。
- 序列学习流程:学习器按照顺序训练,每个新学习器都基于前一个的性能表现进行优化,通过计算学习器权重来确定其在最终组合中的话语权。
- AdaBoost算法
- 训练弱学习器:用当前权重训练学习器
- 计算加权错误率
- 计算学习器权重:错误率越低的学习器权重越高
- 更新样本权重:根据训练结果的正确率,来更新样本的权重,然后循环进入下一轮。
| |
无监督学习
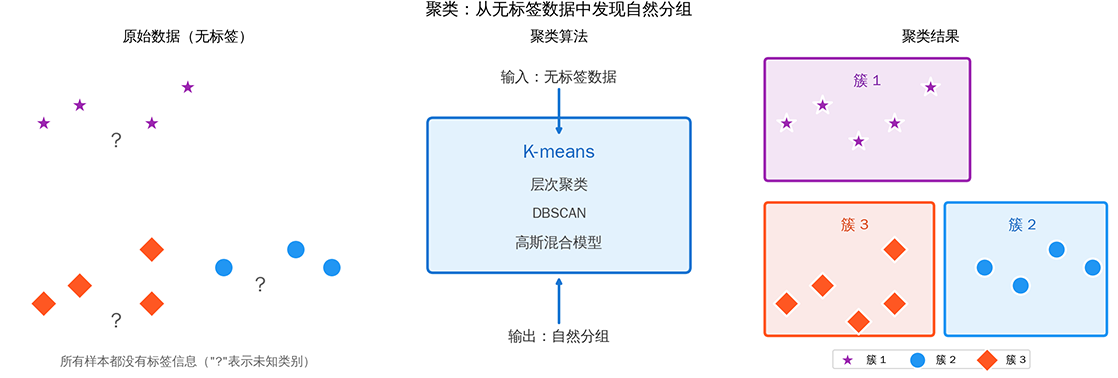
没有正确答案,需要程序在无监督的情况下,自己归纳总结规律的学习。
聚类
将相似的样本汇总在一起
- K-means数学原理